個人報名
 教室租借
 學員須知
 上課地點
 證書申請
 會員註冊
 回首頁


自強課程
課程名稱
【假日實體】視覺語言模型(VLM)與生成式視覺 AI:從 Vision Transformer、CLIP 到多模態大型語言模型實作
熱烈招生中

每位學員必須有自己的Google 帳號以在Colab進行實作
課程代碼:
16W302
上課時間:
116/1/30(六)、1/31(日),9:30-16:30,共二天12小時。
上課時數:
12 小時
課程費用:
12000元
(符合超值優惠價格者需送出報名表後,系統發出報名成功回函確認金額。)
超值優惠:
- VIP企業會員價:VIP企業會員可享優惠價格 (按我)
- 會員優惠價: 會員於開課前七天完成報名繳費者可享會員優惠價 10800 元
- 團報價方案:會員2人同行,可享同行價 10200 元(須於課前告知)
- 會員紅利折抵:本課程歡迎使用紅利折抵,最高可使用 100 點
課程目標:
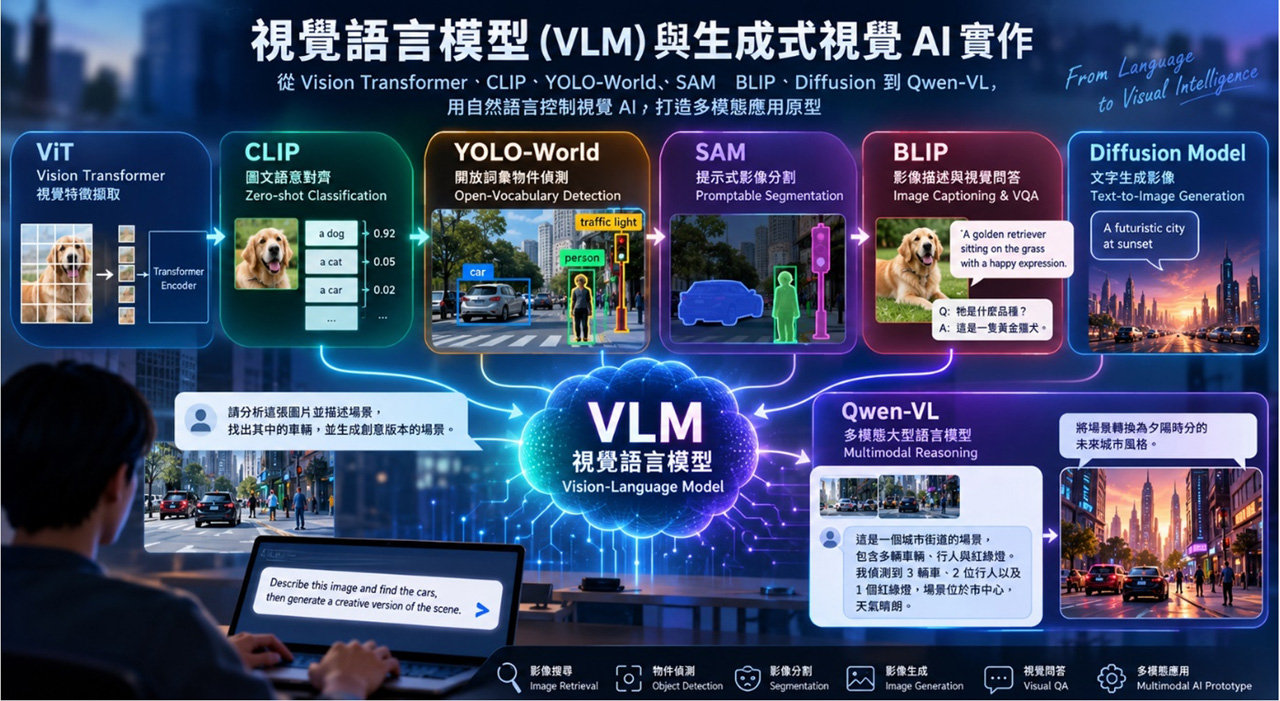
本課程旨在培養學員對視覺語言模型(Vision-Language Model, VLM)與生成式人工智慧核心技術的理解與實作能力,從 Vision Transformer、CLIP 到 YOLO-World、SAM、Diffusion Model 及 Qwen-VL,循序掌握視覺特徵擷取、圖文語意對齊、開放詞彙物件偵測、影像分割、影像生成與多模態推理等關鍵技術。
透過 Google Colab 與預訓練模型的實作練習,讓學員具備運用自然語言控制視覺模型、快速建構多模態 AI 應用原型,以及將相關技術導入實際產業應用的能力。
透過 Google Colab 與預訓練模型的實作練習,讓學員具備運用自然語言控制視覺模型、快速建構多模態 AI 應用原型,以及將相關技術導入實際產業應用的能力。
課程特色:
近年來,生成式人工智慧(Generative AI)技術快速發展,尤其是擴散模型(Diffusion Model)與大型語言模型(Large Language Model, LLM)的突破,使人工智慧從傳統的影像分類、物件偵測與影像分割,逐漸邁向以自然語言驅動的視覺理解與影像生成。
視覺語言模型(Vision-Language Model, VLM)透過整合電腦視覺與自然語言處理技術,讓使用者能夠直接透過文字指令進行影像搜尋、開放詞彙物件偵測、影像分割、圖像生成及視覺問答,大幅提升 AI 系統的彈性與應用範圍。
本課程將從 Vision Transformer(ViT)與 CLIP 的核心架構出發,循序介紹 YOLO-World、Segment Anything Model(SAM)、BLIP、Diffusion Model 與 Qwen-VL 等代表性模型,帶領學員掌握視覺與語言特徵對齊、Zero-shot Learning、Prompt-based Vision、生成式影像模型及多模態大型語言模型的核心技術。
本課程特色包含:
1. 掌握視覺語言模型的核心技術與發展脈絡:
從 ViT 的視覺特徵擷取、CLIP 的圖文對比學習,到 BLIP 與 Qwen-VL 的多模態理解,深入了解視覺語言模型的架構設計與關鍵技術。
2. 學習自然語言驅動的視覺辨識與影像分割:
透過CLIP、YOLO-World 與 SAM,實際體驗 Zero-shot Classification、Open-Vocabulary Object Detection 與 Promptable Segmentation,掌握不需針對每個新類別重新訓練模型,即可透過文字指令執行視覺任務的技術。
3. 探索生成式 AI 與多模態大型語言模型:
介紹 Diffusion Model 的影像生成原理,以及 BLIP、Qwen-VL 的影像描述、視覺問答與多模態推理能力,了解生成式 AI 如何整合視覺與語言資訊,拓展智慧影像分析的應用。
4. 強調 Google Colab 實作與預訓練模型應用:
結合 Python、PyTorch 與 Hugging Face 等工具,透過預訓練模型進行影像分類、圖文檢索、物件偵測、影像分割、文字生成影像及視覺問答等實作,讓學員無需大量運算資源,也能快速建立 AI 應用原型。
5. 整合視覺語言模型建構智慧影像分析系統:
透過串接 YOLO-World、SAM 與 Qwen-VL 等模型,建立結合自然語言指令、物件偵測、影像分割與場景理解的多模態 AI Prototype,培養學員將視覺語言模型應用於智慧製造、自動駕駛、影像標註及智慧監控等領域的實務能力。
視覺語言模型(Vision-Language Model, VLM)透過整合電腦視覺與自然語言處理技術,讓使用者能夠直接透過文字指令進行影像搜尋、開放詞彙物件偵測、影像分割、圖像生成及視覺問答,大幅提升 AI 系統的彈性與應用範圍。
本課程將從 Vision Transformer(ViT)與 CLIP 的核心架構出發,循序介紹 YOLO-World、Segment Anything Model(SAM)、BLIP、Diffusion Model 與 Qwen-VL 等代表性模型,帶領學員掌握視覺與語言特徵對齊、Zero-shot Learning、Prompt-based Vision、生成式影像模型及多模態大型語言模型的核心技術。
本課程特色包含:
1. 掌握視覺語言模型的核心技術與發展脈絡:
從 ViT 的視覺特徵擷取、CLIP 的圖文對比學習,到 BLIP 與 Qwen-VL 的多模態理解,深入了解視覺語言模型的架構設計與關鍵技術。
2. 學習自然語言驅動的視覺辨識與影像分割:
透過CLIP、YOLO-World 與 SAM,實際體驗 Zero-shot Classification、Open-Vocabulary Object Detection 與 Promptable Segmentation,掌握不需針對每個新類別重新訓練模型,即可透過文字指令執行視覺任務的技術。
3. 探索生成式 AI 與多模態大型語言模型:
介紹 Diffusion Model 的影像生成原理,以及 BLIP、Qwen-VL 的影像描述、視覺問答與多模態推理能力,了解生成式 AI 如何整合視覺與語言資訊,拓展智慧影像分析的應用。
4. 強調 Google Colab 實作與預訓練模型應用:
結合 Python、PyTorch 與 Hugging Face 等工具,透過預訓練模型進行影像分類、圖文檢索、物件偵測、影像分割、文字生成影像及視覺問答等實作,讓學員無需大量運算資源,也能快速建立 AI 應用原型。
5. 整合視覺語言模型建構智慧影像分析系統:
透過串接 YOLO-World、SAM 與 Qwen-VL 等模型,建立結合自然語言指令、物件偵測、影像分割與場景理解的多模態 AI Prototype,培養學員將視覺語言模型應用於智慧製造、自動駕駛、影像標註及智慧監控等領域的實務能力。
修課條件:
具備機器學習基礎知識、以及基礎Python程式開發經驗。
課程大綱:
1.Vision Transformer(ViT):
Patch Embedding、Self-Attention、Transformer Encoder 與影像分類
2.CLIP 與視覺語言對齊:
Dual Encoder、Contrastive Learning、Zero-shot Classification、圖文檢索
3.YOLO-World 與 SAM:br>Open-Vocabulary Detection、Text Prompt、Promptable Segmentation
4.BLIP 與多模態理解:
Image Captioning、Vision-Language Fusion、Visual Question Answering
5.Diffusion Model 與文字生成影像:
DDPM、Latent Diffusion、Stable Diffusion、Prompt Engineering
6.Qwen-VL 與多模態 AI 系統整合:
Vision Encoder + LLM、Multimodal Reasoning、整合專題
Patch Embedding、Self-Attention、Transformer Encoder 與影像分類
2.CLIP 與視覺語言對齊:
Dual Encoder、Contrastive Learning、Zero-shot Classification、圖文檢索
3.YOLO-World 與 SAM:br>Open-Vocabulary Detection、Text Prompt、Promptable Segmentation
4.BLIP 與多模態理解:
Image Captioning、Vision-Language Fusion、Visual Question Answering
5.Diffusion Model 與文字生成影像:
DDPM、Latent Diffusion、Stable Diffusion、Prompt Engineering
6.Qwen-VL 與多模態 AI 系統整合:
Vision Encoder + LLM、Multimodal Reasoning、整合專題
課程師資:
自強基金會 林哲聰老師
現任現任瑞典Zenseact(Volvo Cars)自動駕駛深度學習工程師
經歷
▻ 工研院機械所副研究員/研究員/資深研究員
▻ 馬來西亞偉特科技公司(ViTrox)研發顧問
▻ 馬來西亞10 EPOCH科技公司研發顧問
▻ 加州大學聖塔芭芭拉分校資工系訪問研究員
現任現任瑞典Zenseact(Volvo Cars)自動駕駛深度學習工程師
經歷
▻ 工研院機械所副研究員/研究員/資深研究員
▻ 馬來西亞偉特科技公司(ViTrox)研發顧問
▻ 馬來西亞10 EPOCH科技公司研發顧問
▻ 加州大學聖塔芭芭拉分校資工系訪問研究員
主辦單位:
財團法人自強工業科學基金會
學員須知:
注意事項